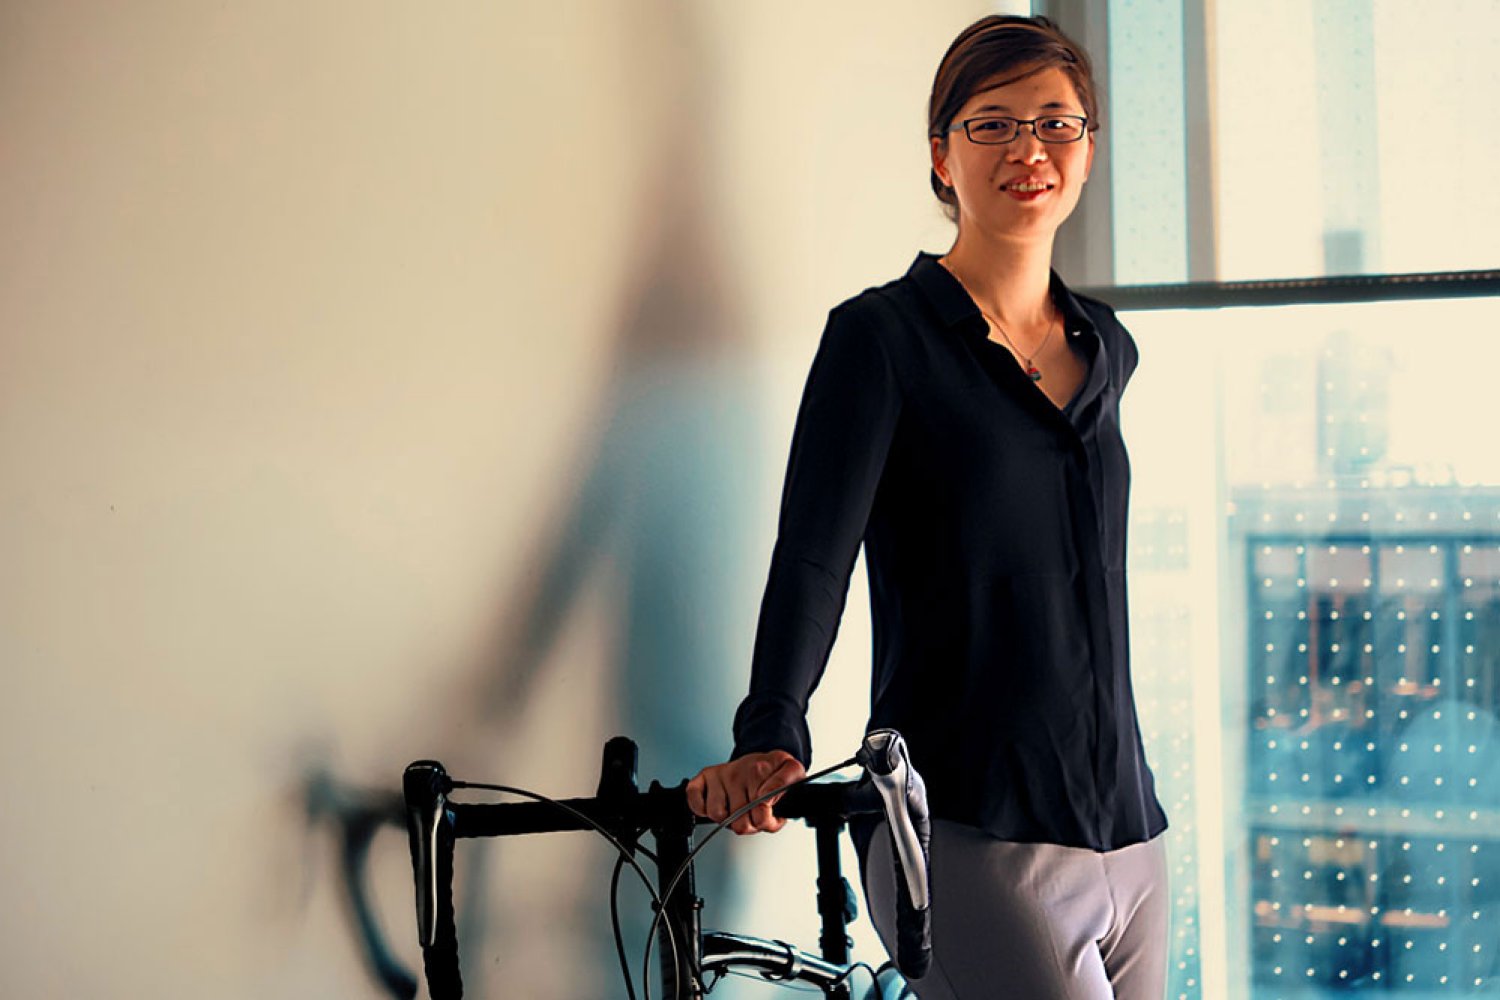
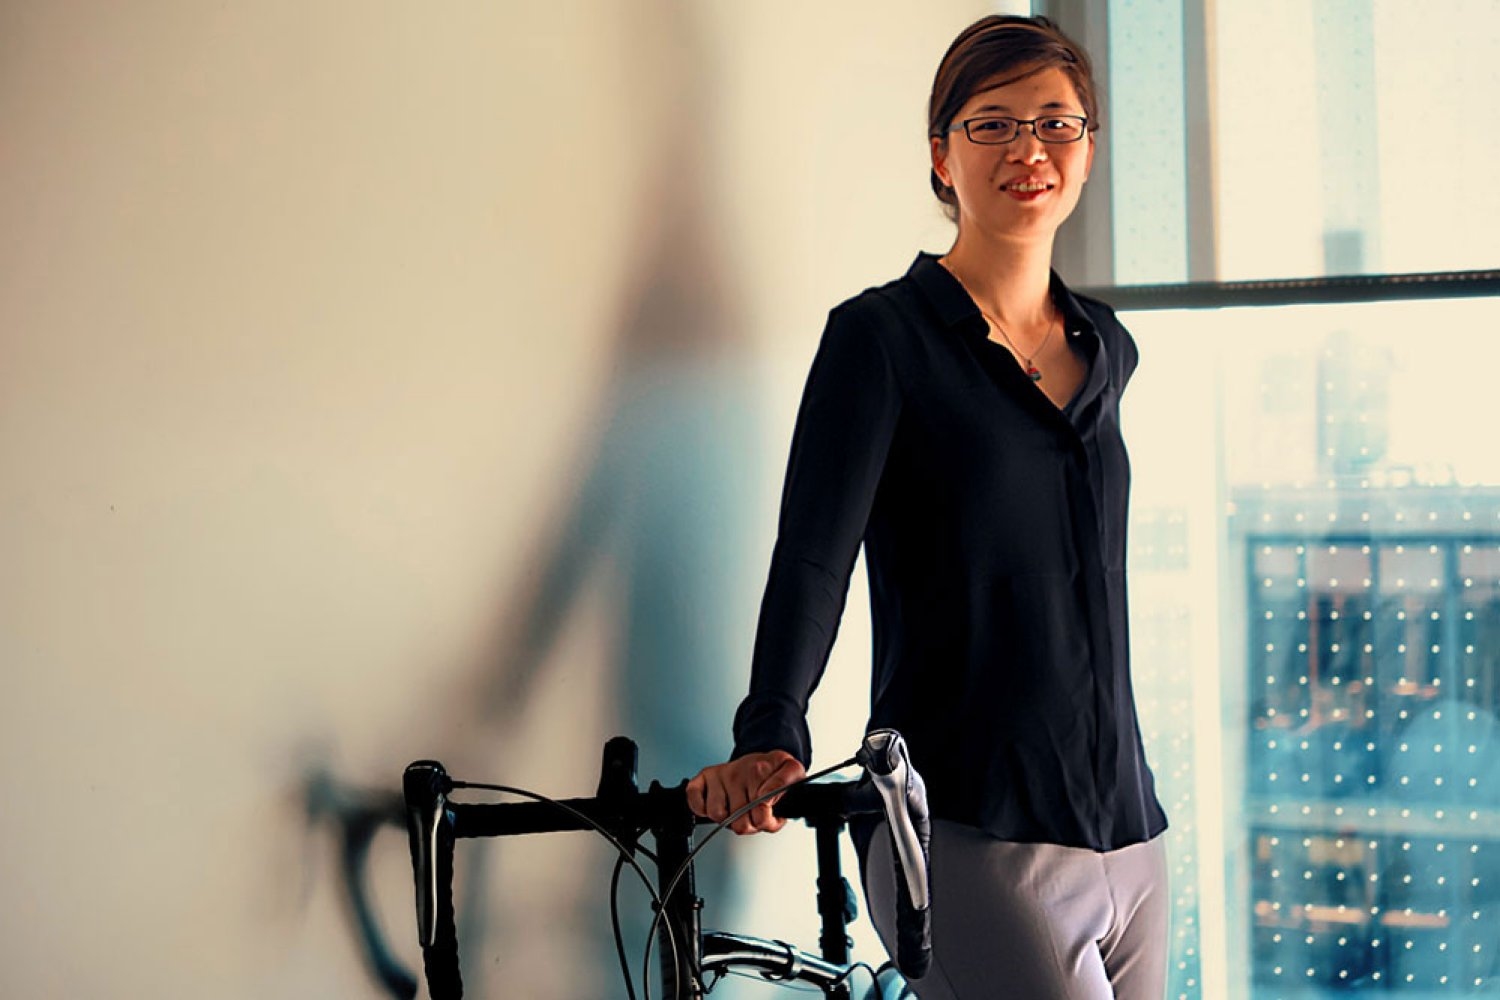
Katie Wu ’12 と MNG ’13 は、覚えている限りずっと、人々の生活を改善するための解決策を見つけたいと考えていました。彼女の両親は台湾からの移民で、父親は通勤に時間がかかり、家族から引き離されました。予算が限られていたため、残りの家族は外で遊ぶことができないほど混雑した通りにある家にいることもよくありました。ウーと彼の姉妹はコンピューター ゲームをよく遊びました。
ウー氏は、世界をより良い場所にしたいという願望、父親の日々の交通との戦い、そして彼がプレイした「シムシティ」などのゲームが、安全で効率的な交通システムを設計する動機の種だったと語ります。
Wu は、MIT 土木環境工学部 (CEE) および情報・システム・社会研究所 (IDSS) の准教授であり、情報システムおよび意思決定研究所の主任研究員でもあります。彼の研究は、交通機関を含むさまざまな複雑なシステムを改善するための信頼できる戦略を開発するための機械学習と強化学習 (RL) の使用に焦点を当てています。
「交通システムの設計には、数百、あるいは数千とは言わないまでも、数十のオプションのモデル化と分析が含まれます。つまり、これらのシステムを設計するための証拠に基づいたアプローチは、今日のツールでは利用できないことを意味します」とウー氏は言います。 「それがRLの役割です。成功すれば、交通研究者は解放され、実験パートナーが望むシステムを設計できるようになります。」
ウーさんは、人々の生活を改善したいという願望を植え付けてくれたのは姉のおかげだと信じており、ウーさんの交通機関への関心はその理想にぴったりです。
「私は交通機関が大好きです。なぜなら、交通機関はすべての人を結び付けるからです。私たちは皆、交通機関を利用し、経験しており、交通機関に関する問題を抱えています。ですから、ある程度のレベルでは、私たち全員がこのシステムをより良くすることに関心を持っています」と彼は語った。
ウー氏は、MIT の学部在学中、故セス・テラー教授の講義を受講した後、交通機関における人工知能の利用に興味を持ちました。ウー氏は、テラー氏がロボット工学コンテスト中に行った講演(実際にウー氏が優勝した)が、交通研究に対する彼の特別なアプローチを発展させた出来事だったと語る。彼はテラーと協力し始めたが、テラーが自動運転車に注力するのをやめると、ロボタクシーの研究をしていたダニエラ・ルース教授に異動するようウーに勧めた。
「これらの興味を探求し、今日の私になるのを助けてくれた人々にとても感謝しています」と彼は言います。特にテラー、ラス、そして交通問題に焦点を当てた 2 回目のインターンシップに誘われた「Dropbox の友人たち」です。
ウーは MIT で修士号を取得した後、博士号を取得しました。カリフォルニア大学バークレー校出身。その間、彼は、交通研究者が新しいシステム オプションをモデル化して分析するための最適化手法の開発に何年も費やしていることに気づきました。交通問題を解決するための RL および最適化手法の開発に取り組むコンピューター科学者としての彼のアプローチは、効率が飛躍的に向上する可能性を秘めていました。
ウー氏はカリフォルニア大学バークレー校での博士課程の最終年である 2018 年に、RL を交通問題に適用することに成功し、さまざまな交通ネットワークにおける自動運転車の潜在的な交通流への影響を自動的に分析しました。この研究は急速に広まりました。
これはウーにとって「あとは歴史だ」という瞬間だったかもしれないが、RLは空を飛ぶ相棒となった。 Wu は Microsoft でポスドクとして RL 理論の研究に取り組み、MIT に戻りました。そこで教授陣は CEE の持続可能性への焦点と、データ サイエンスを他の分野に統合することを重視する IDSS に惹かれました。
しかし、その後 2 年間にわたり、RL を交通問題に適用しようとするウー氏のさらなる試みは失敗に終わりました。
「ストレスがかかりました」とウー氏は言います。「問題が私 (コンサルタント) にあるのか、生徒にあるのか、交通ドメインにあるのか、それとも RL 自体にあるのかは明らかではありませんでした。」
ただし、これまでの研究は、RL が交通システムに適用できるという概念の実証でした。
そして 2022 年に、彼と彼の学生たちは、RL アルゴリズムが非常に敏感であるため、1 つの問題に機能するアルゴリズムが、密接に関連する問題には機能しない可能性があることを発見しました。ウー氏は「否定的な結果の長いトンネルの終わりに一筋の光が差したようなものだったから」と誇りに思う重要な結果が 2023 年に得られた。彼と彼の研究チームは、RL 過敏症を回避する方法を開発した。研究チームは、RL は一連の問題の 90% ではうまくトレーニングできないかもしれないが、10% では非常にうまくトレーニングできることを発見しました。そして、RL モデルを適切に解決できる問題に基づいてトレーニングし、一般化することで、結果として得られるモデルは、直接トレーニングによって解決できなかった問題であっても、一連の関連する問題に対して適切なパフォーマンスを発揮します。研究者らは、トレーニングにどの問題を RL を使用するかを決定するアルゴリズムを設計しました。このアルゴリズムにより、トレーニング効率が最大 30 倍向上しました。これは、通常、トレーニングに 100 個のモデルが必要な場合に必要なモデルが 3 つだけになることを意味します。
「この研究により、強化学習は輸送などの困難な最適化問題を解決する上で重要な役割を果たすことができると確信しました」とウー氏は言います。 「現在、私のグループのかなりの部分がコンテキスト RL に取り組んでいます。これは、RL が関連する問題空間を解決する場所です。」
Wu 氏の最近の研究では、RL を使用して、重要な政策的含意を伴う困難な交通最適化問題を解決しています。この研究では、車両の速度をインテリジェントに制御して過剰な停止と発進を減らすエコドライブ対策により、車両の排出ガスを 11 ~ 22 パーセント削減できることが示されています。このシステムは、そのような措置を講じた政策によってシステム効率が大幅に向上するという証拠を提供し、「現実的に重要な問題について交通政策に情報を提供するために RL を使用できることを示しています」とウー氏は述べています。
「私は証拠に基づく政治の大ファンで、それが民主主義社会の繁栄の基礎だと信じていますが、私たちの公共制度は非常に複雑です」とウー氏は言う。 「人々はいつでも、良いか悪いかについて議論することができますが、私たちが議論している問題には、データを使用して体系的に分析でき、客観的な答えが得られると信じています。私が学術界にいる理由の大きな部分は、テクノロジーが民主主義社会の意思決定をどのようにサポートできるかをより深く理解するためです。」
ウー氏は、彼と彼のチームが過去数年間に行った仕事の多くは、「輸送に関連するものであろうと、物流、サプライチェーン、製造、リソース割り当てなどの他のシステムに関連するものであろうと、難しい最適化問題に対するソリューションの開発を合理化するためにアルゴリズムを使用してきた」と述べています。
「これは私の好みの研究スタイルのことです」とウー氏は言い、「応用基礎研究と呼ばれています」と述べ、そのような研究は実際的な問題を解決し、多くの場合他の実際的な問題に応用される基礎的な知識を開発すると説明します。彼の学生たちは、セキュリティから混雑、アクセシビリティに至るまで、次の問題を調査することから始め、既存の方法ではどこが不十分かを特定し、問題自体が研究の方向性を決定するようにします。
同時に、個人レベルで他者を助けたいというウーの願望は、彼の教えに反映されています。
「教室でも研究指導でも、学生たちと協力するのが大好きです」と彼女は言います。 「いつか誰かに何かを教えることができる日が来るだろう――生徒の中で電球が点灯するのを見たときだ。」
ウー氏は、2023 年の国立科学財団賞などの学術的栄誉を受賞しただけでなく、2025 年のオーレ・マドセン・メンタリング賞など、その教育と指導でも評価されています。
非常に複雑な問題に直面している生徒たちに彼は何と言っていますか?
「辛抱強く、小さなことから始めましょう。社会的影響は生涯にわたる取り組みであり、数年で達成できるものではありません」とウー氏は言う。 「何が起こっているのか、本当の問題がどこにあるのかを本当に理解するには何年もかかります。それまでの間、助けようとしてください。好奇心を持ち、たくさん質問してください。」